
Aggiornato al 17 agosto 2026. Rivedo questo articolo a ogni modifica della documentazione ufficiale. Le revisioni sono in fondo, con la data.
Watermark Claude: cosa marca e cosa non marca
Dal 2 agosto 2026 i modelli Claude rilasciati da quella data marchiano il testo che generano. Una filigrana statistica invisibile. Vale in tutto il mondo, non si disattiva, e non aggiunge nessun carattere nascosto.
Fin qui la notizia, che avrai già letto. Tre cose che nelle sintesi in circolazione non ci sono, e che cambiano il senso della faccenda.
Il watermark marca le parole scelte da Claude
Le tue no. Se gli passi un testo tuo e gli chiedi di sistemare grammatica e punteggiatura, il segnale ha quasi niente a cui aggrapparsi: le parole restano le tue. Lo dice la documentazione ufficiale, in una pagina uscita il 14 agosto.
Il watermark non dimostra chi ha scritto
Dice che Claude è passato di lì. Non sa distinguere fra un testo scritto da Claude e un testo tuo che Claude ha riscritto da cima a fondo.
Il rilevatore pubblico non esiste ancora
Anthropic lo ha annunciato, senza dare una data. Fino ad allora ogni accusa basata sugli strumenti commerciali usa un metodo diverso, senza la chiave, e produce stime.
Quando è entrato in vigore l’obbligo dell’AI Act
Il 2 agosto 2026 sono diventati applicabili gli obblighi di trasparenza dell’articolo 50 del Regolamento europeo sull’intelligenza artificiale. Il paragrafo 2 riguarda chi fornisce sistemi che generano testo, audio, immagini o video sintetici, e impone di marcare gli output in formato leggibile dalle macchine.
A luglio Anthropic aveva firmato, con altri 190 firmatari, il Codice di condotta europeo sulla trasparenza dei contenuti generati. La marcatura di Claude è l’applicazione di quella firma.
Il 14 agosto è uscita la pagina di domande e risposte che spiega il meccanismo e chiarisce parecchie letture della prima settimana.
Le sanzioni previste arrivano a 15 milioni di euro o al 3 per cento del fatturato mondiale, a seconda di quale sia maggiore. Per i modelli già sul mercato prima del 2 agosto c’è tempo fino al 2 dicembre.
Le date e i soggetti obbligati, in sintesi
| Cosa | Chi è obbligato | Da quando | Se non si adempie |
|---|---|---|---|
| Marcare gli output in formato leggibile dalle macchine (art. 50, par. 2) | chi fornisce il sistema che genera testo, audio, immagini o video sintetici | 2 agosto 2026 | fino a 15 milioni di euro o al 3% del fatturato mondiale annuo, a seconda di quale sia maggiore |
| Dichiarare il contenuto generato al pubblico (art. 50, par. 4) | chi usa il sistema e pubblica testi destinati a informare il pubblico su questioni di interesse pubblico | 2 agosto 2026 | stesso regime sanzionatorio. Non si applica se c’è revisione umana e un responsabile editoriale |
| Adeguamento dei modelli già sul mercato | chi fornisce modelli immessi sul mercato prima del 2 agosto 2026 | 2 dicembre 2026 | il periodo di transizione si chiude, poi valgono gli obblighi pieni |
Regolamento (UE) 2024/1689, articolo 50. Il quadro sanzionatorio è quello generale del regolamento: l’importo effettivo dipende dalla violazione contestata.
Come funziona il watermark di Claude
Quando si sente dire watermark invisibile nel testo, la prima immagine è quella dei caratteri nascosti. Spazi a larghezza zero, apostrofi strani, selettori Unicode. Roba che si trova con un editor esadecimale e si toglie con una sostituzione in tre secondi. Come sistema di provenienza varrebbe zero.
Il metodo è un altro
Anthropic ha dichiarato che il watermark di Claude è una versione di SynthID-Text, l’approccio che Google DeepMind ha pubblicato su Nature nel 2024, dentro una famiglia di tecniche che risale a una proposta di Scott Aaronson del 2022.
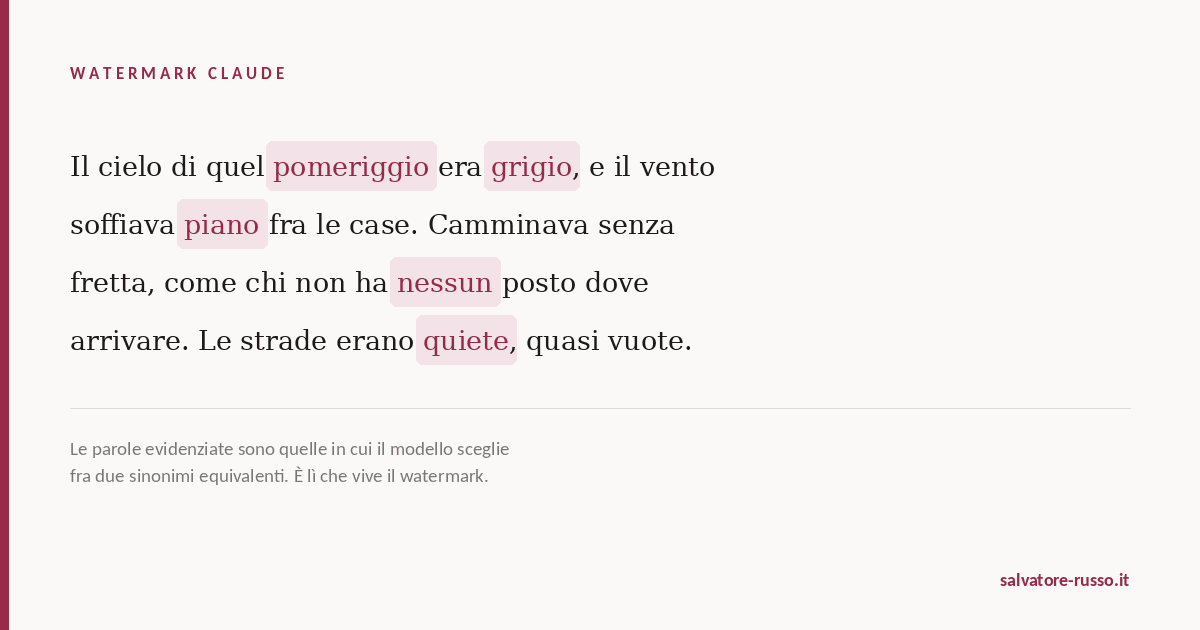
Il modello genera una parola alla volta e ogni volta sceglie fra più candidati plausibili. Nella frase “il tempo oggi era freddo e…”, difficilmente la parola dopo sarà “zuccherina”. Potrebbe essere “coperto”, potrebbe essere “grigio”. Per chi legge non cambia niente. La scelta la decide un numero casuale.
Il watermark lavora lì dentro
Non cambia le parole che il modello considera. Cambia da dove viene la casualità: al posto di un generatore qualunque, il modello usa una chiave segreta combinata con le parole precedenti. Chi ha la chiave può verificare se quella sequenza è compatibile con le scelte che Claude avrebbe fatto usandola, e assegnare una probabilità.
Anthropic la spiega con il Monopoli
Invece di tirare i dadi, i giocatori usano le cifre del pi greco partendo da un punto a caso. Per i giocatori è identico, la partita è la stessa. Ma chi conosce la sequenza, a partita finita, può ricostruire che quei movimenti venivano dal pi greco e non dai dadi.
Nessun carattere aggiunto
Nessun token in più, quindi nessun costo in più. Nessuna informazione su di te: il watermark non contiene e non permette di ricostruire chi ha scritto, per quale azienda, in quale conversazione.
Quando il watermark non viene applicato
Questa è la parte che serve davvero, ed è quella che le sintesi hanno riportato peggio. Il watermark vive nelle scelte fra parole equivalenti. Dove quelle scelte non ci sono, il segnale non ha spazio.
| Situazione | Comportamento del watermark |
|---|---|
| Testo lungo generato da Claude | marcatura piena. Più il modello scrive, più decisioni prende, più spazio ha il segnale |
| Testo breve | rilevamento inaffidabile. Poche scelte, poca informazione |
| Passaggi fattuali | marcatura scarsa. Dopo “l’opera più celebre di Newton si chiama” l’unica risposta è Principia: niente su cui agire |
| Codice | marcatura scarsa. Dove l’output deve essere esatto la modifica non si applica. Resta possibile nei commenti, con effetto trascurabile |
| Correzione di bozze | segnale minimo o assente. Se quasi tutte le parole sono tue, il watermark ha poco a cui aggrapparsi |
| Traduzione | marcatura piena. In una traduzione ogni parola la sceglie il modello |
| Riscrittura completa a mano | il watermark sparisce. Un editing leggero probabilmente no, una riscrittura che cambia ogni parola sì |
Fonte: documentazione ufficiale Anthropic, 14 agosto 2026.
Il watermark marca le correzioni di bozze?
Poco o niente. E qui c’è la parte interessante.
Ne ho scritto su LinkedIn qualche giorno fa, quando la documentazione disponibile diceva che l’output può portare il marchio anche se le idee sono di altri. Il 14 agosto è uscita la pagina che precisa il meccanismo, e il quadro si articola meglio: il watermark marca solo le parole scelte dal modello, quindi su una correzione di grammatica e punteggiatura ha pochissimo a cui aggrapparsi.
Il paradosso però resta, e la stessa pagina lo ammette. Il watermark non sa distinguere fra un testo scritto da Claude e un testo umano che Claude ha riscritto pesantemente. Scrivi tu, chiedi una revisione profonda, ottieni un testo marcato pur avendo pensato ogni cosa. Ti fai scrivere tutto dal modello, riscrivi a mano, ottieni un testo pulito.
Il segnale misura quanto il modello ha toccato le parole. Le idee non le misura nessuno.
Cosa dimostra e cosa non dimostra un watermark rilevato
Tre frasi che sembrano simili e non lo sono. Confonderle è all’origine di metà delle discussioni sbagliate di questi giorni.
“Il testo contiene un watermark Claude.”
Un modello Claude è passato di lì. Non sappiamo quanto, non sappiamo se ha scritto o riformulato, non sappiamo di chi siano le idee.
“Il testo non contiene un watermark Claude.”
Non dimostra che l’ha scritto una persona. Poteva essere un altro modello, con una chiave diversa o un metodo diverso. Poteva essere un testo di Claude riscritto. Poteva essere troppo corto per lasciare un segnale.
“Il testo l’ha scritto una persona.”
Il watermark non è in grado di dimostrarlo. In nessuna delle due direzioni.
Anthropic dichiara anche che la marcatura non tocca proprietà e responsabilità legale dell’output, e non cambia i diritti previsti dai termini di servizio.
Falsi positivi e accuse di uso dell’AI: il rischio reale
Il problema non è la tecnologia. Sono le persone che dovranno usarla per decidere in fretta su molti materiali: comitati editoriali, commissioni accademiche, uffici del personale, clienti.
Un caso c’è già stato. Apex Magazine ha ritirato un racconto dal numero 153 dopo la pubblicazione, per il sospetto che fosse generato. Il racconto aveva superato la selezione. Era uscito. La gente l’aveva letto. Poi è arrivato il sospetto ed è sparito.
In accademia lo chiamano perceptual harm: il danno che subisci quando gli altri sospettano che tu abbia usato l’AI, che il sospetto sia fondato o no.
L’asimmetria la conosciamo tutti. Quando automatizza un’infrastruttura industriale, il mercato la chiama innovazione di processo. Quando lo stesso strumento lo usa un professionista, il committente lo chiama scorciatoia e chiede lo sconto.
Con un rilevatore in circolazione, quello squilibrio si prende uno strumento. E se il rilevatore diventa un verdetto invece che un indizio, produrrà espulsioni, contratti rescissi e reputazioni bruciate su un segnale che, per come è costruito, non può dimostrare quello che gli si chiede di dimostrare.
Nascondere il processo non ti difende. Documentarlo sì. Chi tiene versioni datate, note di ricerca, fonti e passaggi di revisione può ricostruire come è nato un lavoro. Chi consegna solo il file finale, davanti a un sospetto, deve dimostrare un negativo. Buona fortuna!
AI Act e contenuti: chi deve dichiarare l’uso dell’intelligenza artificiale
Qui smettiamo di parlare di norme e cominciamo a parlare di lavoro.
L’obbligo di dichiarare non è di chi fornisce il modello
L’articolo 50 separa due soggetti. Il paragrafo 2 obbliga il fornitore a marcare in formato leggibile dalle macchine. Il paragrafo 4 riguarda chi usa il sistema e pubblica: per i testi generati destinati a informare il pubblico su questioni di interesse pubblico è prevista la divulgazione, salvo revisione umana con un responsabile editoriale. Il watermark parla alle macchine. L’etichetta visibile è un’altra cosa e tocca a chi pubblica.
Adesso la dichiarazione si può controllare
Prima, dire o non dire di aver usato l’AI era una scelta reputazionale senza conseguenze, perché nessuno poteva verificare. Con un segnale di provenienza verificabile, chi dichiara si allinea a un fatto controllabile. Chi tace si prende un rischio che prima non correva.
Sulla visibilità nei motori di risposta preferisco essere preciso
Non esiste, oggi, nessuna evidenza pubblica che i sistemi generativi penalizzino o premino un contenuto per la presenza di un watermark. Chi lo scrive sta tirando a indovinare, e in queste settimane ne ho letti parecchi.
Quello che si osserva è un’altra cosa, e si può verificare: i motori di risposta scelgono come fonti chi pubblica materiale che le altre fonti non hanno. Dati propri, rilevazioni, misure. Il watermark non cambia questo criterio. Cambia il costo di produrre contenuto indistinguibile, che diventa più facile da fare e più facile da riconoscere.
Risultato: il vantaggio si sposta ancora di più verso chi produce materiale verificabile invece di volume. Stava già succedendo. Questa storia lo accelera.
Come usare l’AI nel lavoro professionale: cinque regole
Lavoro sul posizionamento di marca da ventidue anni. Discutere se usare l’AI è tempo buttato. Conta come la usi, e queste sono le regole con cui lavoro.
1. All’AI si danno le montagne di dati
Macina in un’ora quello che ti costerebbe settimane. Poi leggere quei numeri e capire cosa dicono di quella specifica azienda è mestiere tuo.
2. Se non sai fare quel lavoro a mano, lascialo stare
Non puoi giudicare l’output di un mestiere che non padroneggi. Chi non conosce la regola non si accorge quando il modello la infrange.
3. Ogni numero torna alla fonte
Il modello non firma niente. Se un dato sbagliato arriva al cliente, sopra c’è la tua firma.
4. Il posizionamento non può fartelo un piccione
L’AI ti accompagna nel processo. Definire chi sei, e soprattutto chi non sei, resta lavoro tuo: serve una cultura d’impresa che nessuna inferenza probabilistica possiede.
5. Alla consegna conta una domanda sola
È il lavoro migliore che potevo fare per questo cliente? Chi o cosa ci ha lavorato resta un dettaglio di processo, se le prime quattro regole le hai rispettate.
A maggio Canva ha lanciato in Italia una campagna il cui messaggio è che anche un piccione può fare branding. Quello spot è in stop motion, girato fotogramma per fotogramma, diretto da Dan Richards, ex animatore di Aardman, lo studio di Wallace & Gromit. Ogni pezzo della scenografia, piccione compreso, costruito a mano.
Una piattaforma che vende design per tutti, per dire chi è, ha pagato a peso d’oro l’artigianato più lento che esista. Provano ad appiattirci da anni e intanto continuano a pagare chi sa fare.
Domande frequenti
Il watermark si può disattivare?
No. Non c’è un’impostazione, un parametro dell’API o un piano a pagamento che lo escluda.
Vale anche fuori dall’Unione Europea?
Sì. Anthropic ha dichiarato di applicarlo ovunque perché non ha ancora un modo stabile per limitarlo per area geografica, e di stare valutando altre strade.
Riguarda tutti i modelli Claude?
I modelli lanciati dal 2 agosto 2026 lo hanno dal rilascio. Per i precedenti il supporto arriva durante il periodo di transizione previsto dalle regole europee. Se oggi controlli l’output di un modello vecchio e non trovi niente, non hai dimostrato niente.
Vale su tutte le superfici?
Sì. Il segnale sta dentro il modello, quindi vale nell’app, via API, in Claude Code e negli altri strumenti, e anche quando il modello passa dai principali fornitori cloud.
Come funziona per le immagini e i file?
In un altro modo. Ai file supportati come .png, .jpg e .svg viene allegata una credenziale firmata nei metadati, secondo lo standard aperto C2PA. Il file non cambia. Questa marcatura è fragile: la perdi con una conversione di formato, un nuovo salvataggio o uno screenshot.
Il watermark identifica me o la mia azienda?
No. Non contiene niente su di te, sulla tua organizzazione o sulle tue conversazioni, e la chiave non permette di ricostruirlo.
Rallenta il modello o costa di più?
No. L’impatto sulla velocità è trascurabile e non produce token aggiuntivi.
Come si distingue dai rilevatori commerciali di testo generato?
Quelli la chiave non ce l’hanno. Cercano indizi stilistici ricorrenti e restituiscono una stima di natura diversa. Un dettaglio che mi ha fatto sorridere: fra gli indizi che la stessa documentazione di Anthropic cita come tipici della scrittura generata c’è la costruzione “non è X, è Y”. È una delle formule che vieto da anni nei testi che escono dal mio studio.
Cosa fare adesso: professionisti, clienti, fornitori
Se pubblichi contenuti
Controlla se ricadi nell’obbligo di divulgazione previsto per i testi generati destinati a informare il pubblico su questioni di interesse pubblico, e come si applica l’eccezione della revisione umana con responsabile editoriale. È materia legale, falla vedere a chi la conosce.
Se lavori con clienti
Metti per iscritto, prima e non dopo, quale uso degli strumenti prevede il tuo processo e quale responsabilità resta tua. Un accordo esplicito vale più di qualsiasi discussione a posteriori su un rilevatore.
Se ricevi contenuti da fornitori
Un rilevamento è un indizio. Mai un verdetto. Il segnale non distingue fra scrittura ed editing e sulle idee non dice niente.
In ogni caso
Tieni traccia del tuo processo: versioni datate, fonti, note, passaggi di revisione. È l’unica difesa che regge, e serve anche quando nessuno ti accusa di niente.
Come è stato prodotto questo articolo
Sostenere che la trasparenza sul processo conviene, e poi non praticarla, sarebbe una posizione ridicola.
Questo articolo nasce da un mio post su LinkedIn, dalla verifica delle fonti che ne è seguita e dalla documentazione aggiornata al 14 agosto. La struttura, la tesi, la scelta delle fonti e le cinque regole sono mie. Ho usato un modello linguistico per la ricerca documentale, il confronto fra le fonti e la revisione del testo.
Ogni affermazione fattuale qui dentro è verificabile nelle fonti sotto, con la data. Se trovi un errore scrivimi: aggiorno l’articolo e la correzione finisce nel registro delle revisioni.
Fonti
- Anthropic, How Claude’s text watermark works, 14 agosto 2026, anthropic.com
- Anthropic, centro assistenza, How Claude marks AI-generated content, aggiornato all’11 agosto 2026
- Regolamento (UE) 2024/1689, articolo 50, applicabile dal 2 agosto 2026
- Commissione europea, Code of Practice on Transparency of AI-generated Content, luglio 2026
- Google DeepMind, SynthID-Text, Nature, 2024
- Kirchenbauer, Geiping, Wen et al., A Watermark for Large Language Models, 2023
- Aaronson, proposta sul watermarking dei modelli linguistici, 2022
- Copertura giornalistica indipendente: Forbes, Euronews, The Next Web, TechCrunch, Tom’s Hardware, agosto 2026
Registro delle revisioni
17 agosto 2026. Prima pubblicazione, aggiornata alla documentazione ufficiale del 14 agosto: identificazione del metodo come versione di SynthID-Text, comportamento del watermark sulle correzioni di bozze, annuncio del rilevatore in arrivo.


